
POST 요청이 301 리다이렉트를 받으면 GET으로 바꿔도 될까요? AI 코딩 도구는 이런 질문에도 망설임 없이 답하지만, 그 답이 표준 문서의 어느 문장에서 나왔는지는 대개 말해 주지 않죠. grounded-expert는 개발자 pko89403이 2026년 10월 GitHub에 공개한 클로드 코드용 스킬(MIT 라이선스)로, 도메인 질문을 받으면 서브에이전트가 공식 스펙·문서·표준을 실시간으로 찾아 답의 주장과 대조해 줘요.
아직 널리 알려진 도구는 아니에요. 2026년 11월 9일 기준 GitHub 별은 1개, 공개 언급도 만든 사람이 11월 5일 긱뉴스에 올린 소개 글 정도입니다. 그런데도 살펴볼 이유는 접근 방식에 있어요. AI에게 더 많은 자료를 먹이는 대신, 답을 내는 절차를 바꾸거든요. 이 글은 저장소와 문서를 읽고 쓴 것이고, 설치해 돌려 보지는 않았습니다. 공개된 데모도 찾지 못했어요.
전문가 연기 대신 찾아보는 절차
만든 사람의 문제의식은 단순합니다. 「당신은 HTTP 전문가다」 같은 페르소나 프롬프트는 모델이 기억으로 답하게 만들고, 모델은 틀린 사실도 맞는 사실처럼 말한다는 거예요. 전문가와의 차이는 찾아보고, 근거를 대고, 틀리면 고치는 절차에 있다고 봅니다. 와튼 연구진의 2025년 12월 보고서도 비슷한 방향을 가리켜요. GPQA Diamond와 MMLU-Pro 문항에서 전문가 페르소나는 사실 정확도를 일관되게 높이지 못했다고 합니다(Gemini 2.0 Flash는 예외로 언급되고, 어조 조절 같은 쓸모는 있을 수 있다고 덧붙였어요).
결과물에서 가장 눈에 띄는 건 검증 가능한 주장마다 붙는 표예요. 주장, 근거 수준 태그, 원문 인용, 출처, URL이 한 줄에 놓입니다. 답을 믿을지 말지 정할 재료가 답 안에 같이 들어오는 셈이죠.
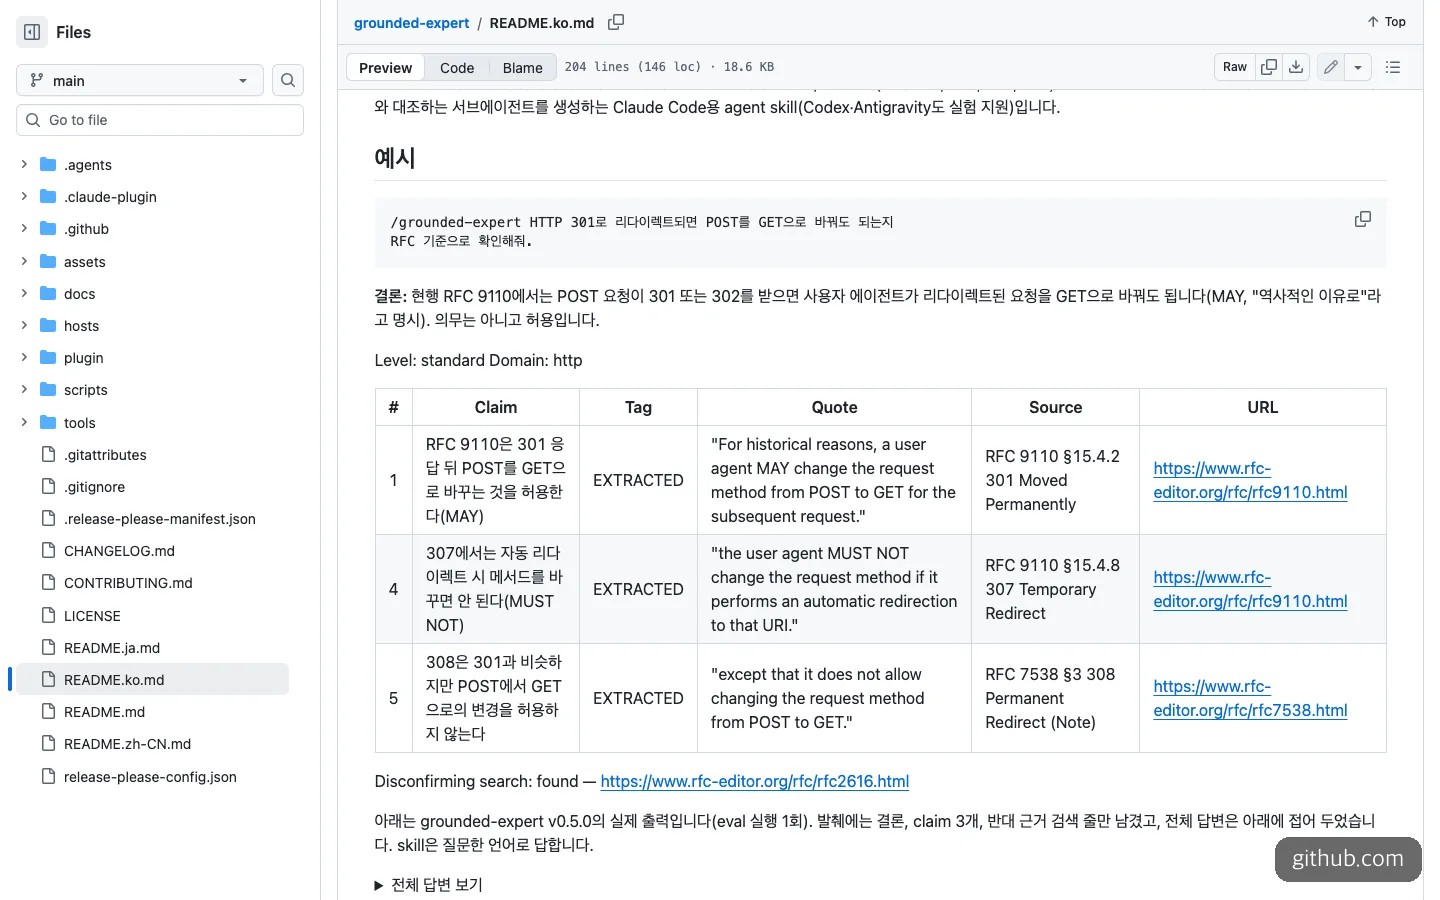
HTTP 301 질문에 결론과 주장별 인용, 반대 근거 검색 결과를 함께 낸 예시 답변.
| 태그 | 뜻 | 읽는 사람의 태도 |
|---|---|---|
| EXTRACTED | 1차 출처의 문구를 URL 하나로 그대로 인용 | 링크를 열어 문구만 대조 |
| INFERRED | 어느 한 구절에 그대로 적혀 있지 않은 주장(2차 출처 경유 포함) | 추론이 맞는지 따져 볼 대상 |
| not confirmed | 연 페이지 중 뒷받침하는 곳이 없음 | 사실로 쓰지 않기 |
| REUSED | 최근 검증해 둔 기록에서 다시 쓴 항목 | 그사이 문서가 바뀌었는지 의심 |
README 예시에서 인상적인 대목은 영문 답변 첫머리예요. 요약하는 가져오기 도구를 거쳤으니 인용문은 도구가 재현한 것이고, RFC 원문을 직접 읽지는 않았다고 스스로 밝힙니다. 다만 화면에 보이는 태그는 전부 EXTRACTED여서, 근거를 못 찾았을 때 답이 어떤 모습인지는 이 발췌로 알 수 없어요. 예시 자체도 v0.5.0으로 한 번 돌린 기록이라 최신판 출력과 다를 수 있습니다.
지침 파일을 열어 보면 절차가 꽤 구체적이에요. 페르소나 문구를 쓰지 말라고 못 박았고, 기본 수준에서는 독립 출처 2개 이상과 반대 근거 검색을 요구합니다. 검색이나 가져오기가 모두 실패하면 기억으로 메우지 않고 답 맨 위에 그 사실을 밝히게 되어 있고요.
grounded-expert는 언제 쓰면 좋을까요
기준은 하나로 충분해요. 답이 틀렸을 때 치르는 값이 토큰 값보다 비싼가, 그리고 그 답을 확인해 줄 공식 문서가 세상에 있는가. 둘 다 그렇다면 걸어 볼 만합니다.
잘 맞는 경우는 이렇습니다.
- 표준이나 스펙의 허용 범위를 확인할 때. 301과 307의 차이처럼 MAY와 MUST NOT 한 단어로 구현이 갈리는 질문이에요.
- 결정의 근거를 남겨야 할 때. 인용과 URL이 표로 남으니 나중에 왜 그렇게 만들었는지 되짚기 쉽죠.
- 이미 쓴 문장을 검증할 때. 만든 사람은 한국어 README 번역을 이 스킬로 검수했다고 문서 맨 위에 적어 두었어요.
맞지 않는 경우도 분명해요. 대화나 코드베이스만으로 답이 나오는 질문은 스킬이 건너뛰도록 설계되어 있습니다. 모델이 이미 잘 답하는 쉬운 질문도 마찬가지예요. 만든 사람 스스로 그런 질문에서는 정확도 향상이 작다고 밝혔거든요. 코드를 짜는 동안 라이브러리 최신 사용법을 계속 넣어 주고 싶다면 아래에서 비교할 Context7 쪽이 낫습니다.
설치하고 쓰는 법, AI에게 건넬 문장
준비물은 클로드 코드와 웹 검색·URL 가져오기 도구예요. README 기준으로 별도 API 키 안내는 확인되지 않았지만, 호출할 때마다 실제 사용량은 발생합니다. 클로드 코드 대화창에 문서에 적힌 대로 입력하면 돼요.
/plugin install grounded-expert --marketplace pko89403/grounded-expert이 형식은 클로드 코드 2.1.275 이상에서 동작하고, 클로드 코드 바깥 터미널에서 claude plugin install로 설치하려면 2.1.292 이상이 필요합니다.
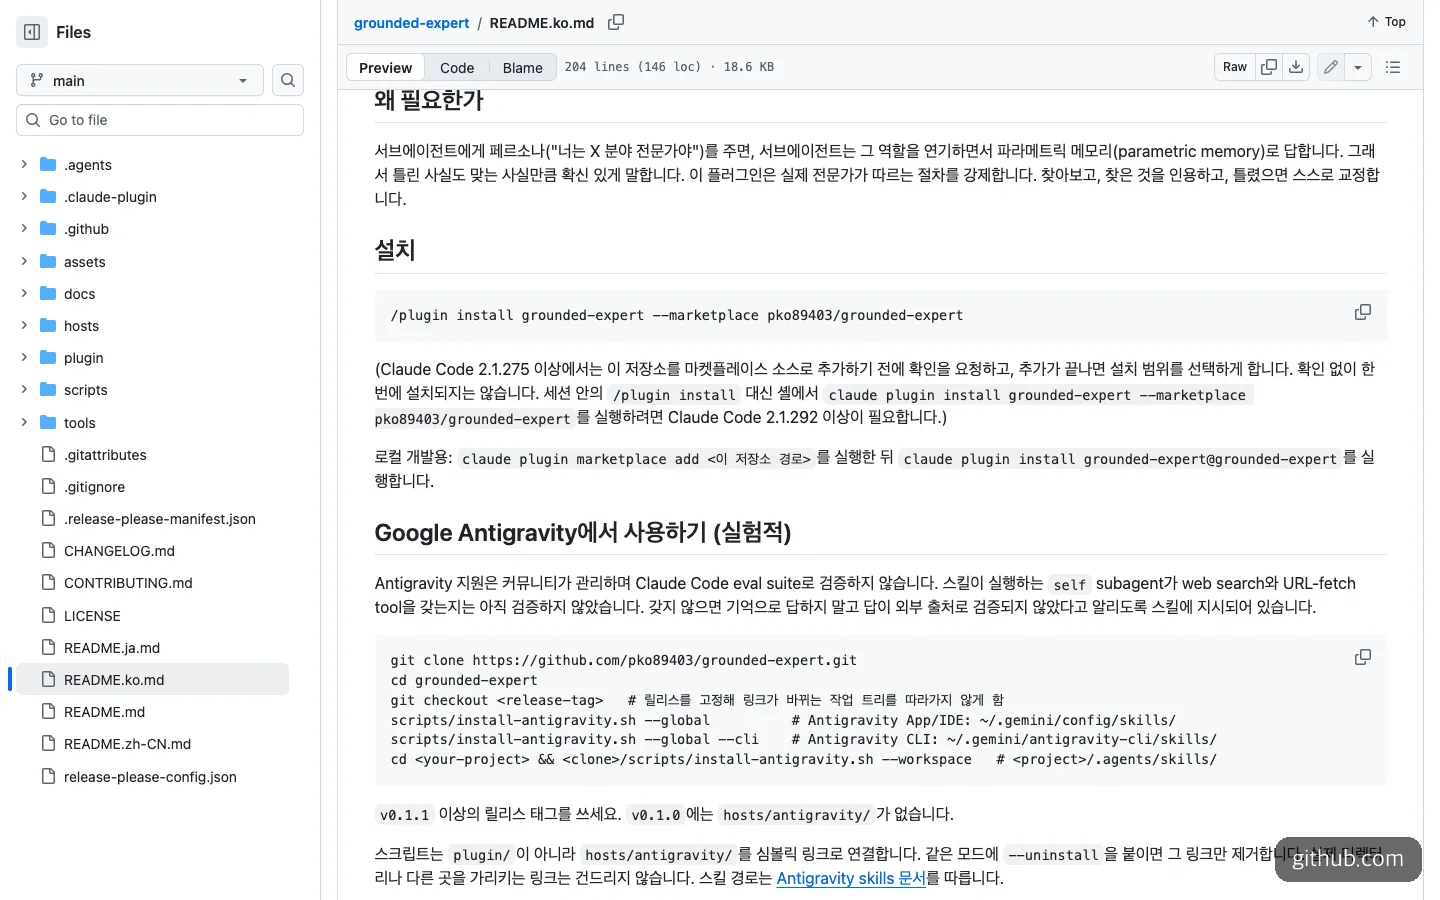
설치 명령 한 줄과 클로드 코드 버전 조건이 적힌 한국어 README.
설치하기 전에는 클로드 코드에 먼저 이렇게 맡기는 편이 안전해요.
아직 설치하지 말고 github.com/pko89403/grounded-expert 의 plugin 폴더를 읽어 줘.
hooks/hooks.json, .mcp.json, bin/ 이 있는지, 있다면 내 컴퓨터에서 무엇을 실행하는지 쉬운 말로 설명해 줘.
사용은 질문 앞에 슬래시 명령을 붙이는 방식입니다. 도메인 사실의 정확도가 필요한 질문이면 자동으로 발동하기도 해요. 질문에는 어떤 문서를 기준으로 삼을지까지 적어 두면 범위가 좁아집니다.
/grounded-expert HTTP 301로 리다이렉트되면 POST를 GET으로 바꿔도 되는지 RFC 기준으로 확인해줘.README 표기는 위와 같지만, 클로드 코드 문서는 플러그인 스킬을 /플러그인:스킬 꼴로 안내하니 슬래시 메뉴에서 실제 이름을 확인하면 헷갈리지 않아요. 실행 전에는 계획 카드가 뜨고 확인을 받습니다. 사람이 없는 자동화 환경에서는 여기서 멈추므로, 문서가 안내한 대로 프롬프트에 Pre-approved: run the subagent now; do not ask for confirmation. 문구를 넣어야 하고요.
검증 수준별 토큰과 시간
수준은 세 가지예요. quick은 출처 1개에 반대 근거 검색이 없고, 기본값인 standard는 독립 출처 2개 이상에 반대 근거 검색까지 합니다. thorough는 여기에 출처 유형별 병렬 서브에이전트의 교차 검증을 더하죠.
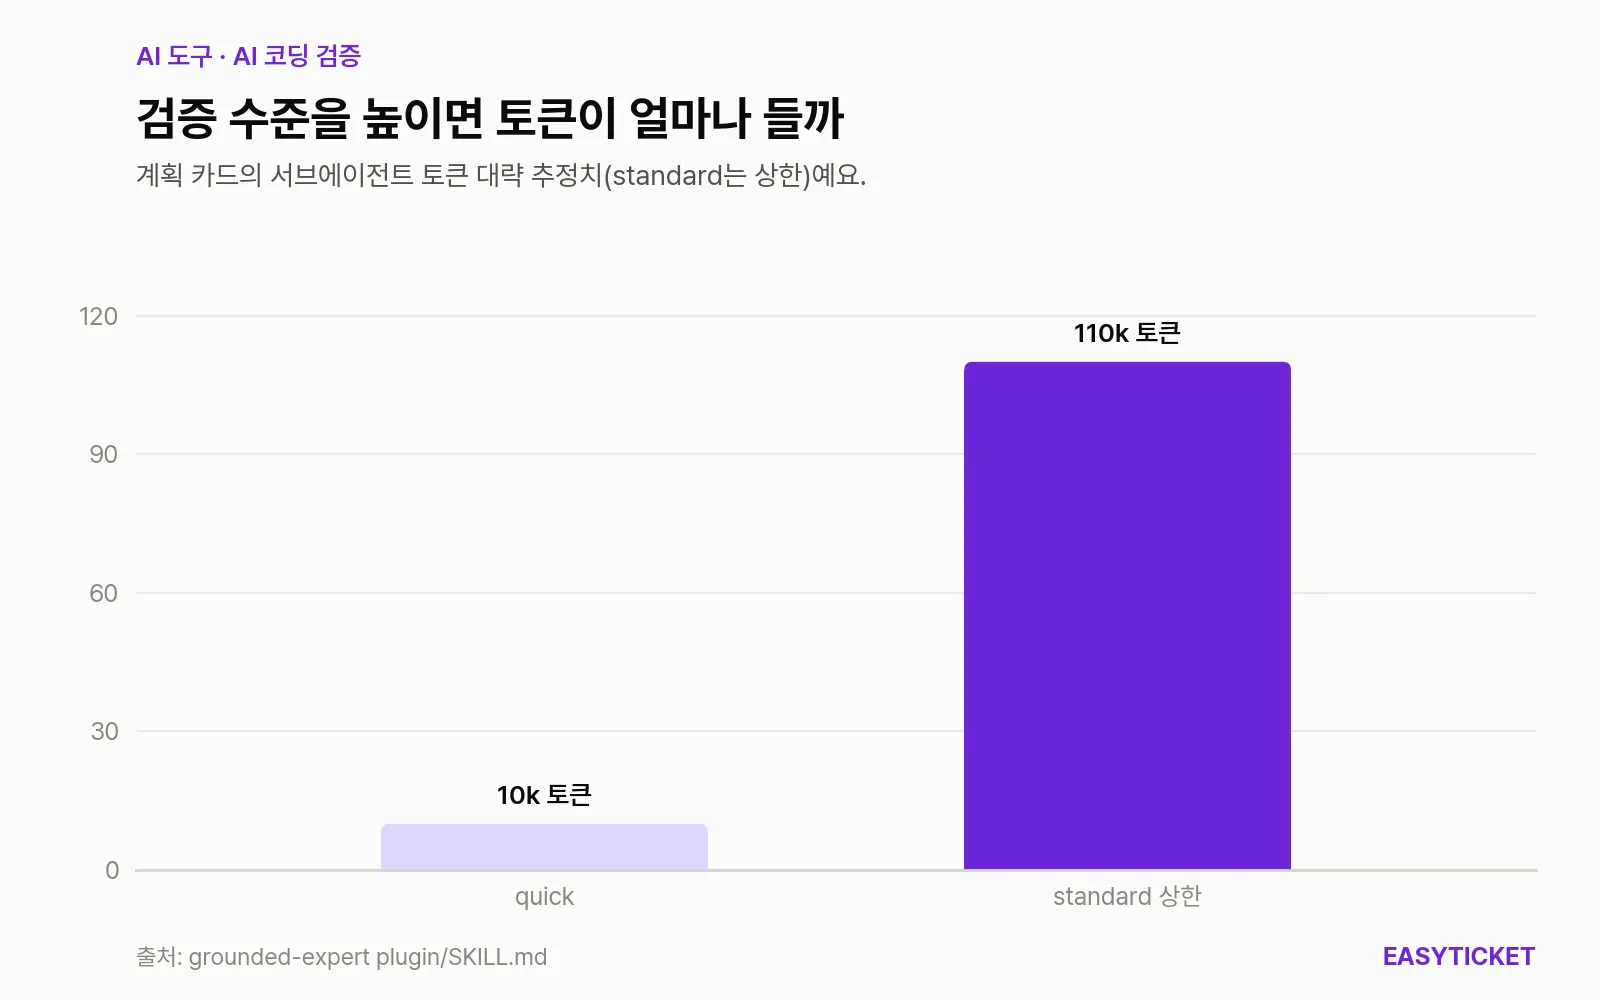
계획 카드에 적힌 서브에이전트 토큰 추정치. standard는 범위의 상한을 그렸어요.
그래프가 보여 주는 건 기본값의 상한이 quick의 열한 배까지 벌어진다는 점이에요. 지침에 적힌 대략적인 추정치로 quick은 약 1만 토큰에 1분 미만, standard는 약 1만~11만 토큰에 1~10분이 걸립니다. 여러 부분으로 된 질문은 더 길어지고, thorough는 아직 측정값이 없어요. 작업 흐름 중간에 몇 분을 기다릴 만한 질문인지 먼저 가려야 하는 이유입니다.
Context7, GitMCP와 무엇이 다를까
셋 다 AI가 기억에 기대지 않게 해 주지만 하는 일은 달라요. 비교 대상 중 가장 널리 쓰이는 Context7과 GitMCP는 문서를 공급하고, grounded-expert는 답의 주장을 검증합니다.
| grounded-expert | Context7 | GitMCP | |
|---|---|---|---|
| 하는 일 | 공식 출처를 찾아 주장별로 인용과 태그 부여 | 라이브러리의 버전별 문서와 코드 예제 전달 | GitHub 저장소·Pages를 AI용 문서 허브로 변환 |
| 잘 맞는 때 | 스펙·표준 사실 확인 | 코딩 중 최신 API 참고 | 특정 저장소 문서를 읽힐 때 |
| 시작 | /plugin install 한 줄 | npx ctx7 setup(Node.js 22.13 이상) | MCP 설정에 gitmcp.io/{owner}/{repo} 입력 |
| 라이선스 | MIT | MIT(서버 코드만, 백엔드 비공개) | Apache 2.0 |
| GitHub 별(2026년 11월 9일) | 1개 | 64.4k개 | 약 8.5k개 |
매일 코딩에 곁들일 도구 하나만 고른다면 Context7이 먼저예요. 사용자가 압도적으로 많고, 일상적인 코딩 질문에는 몇 분씩 검증을 돌릴 필요가 없으니까요. 다만 Context7 README는 문서 내용이 커뮤니티 기여이며 정확성과 보안을 보장하지 않는다고 적어 둡니다. 둘은 경쟁보다 분업에 가까워서, 평소엔 문서 공급 도구를 쓰다가 틀리면 곤란한 질문에만 grounded-expert를 거는 조합이 자연스러워요.
걸기 전에 알아 둘 한계
가장 먼저 짚을 건 효과가 아직 숫자로 증명되지 않았다는 점이에요. 만든 사람은 검색 때문에 더 느리고 토큰도 더 든다고 인정했고, 모델이 틀리는 질문에서의 효과는 측정 중이라고 밝혔습니다. README도 지침이 강제 보장이 아니라고 적어요. 인용과 URL이 붙었다고 맞는 답이 되는 건 아니니, 중요한 결정이라면 링크 하나는 사람이 열어 보는 게 이 도구를 제대로 쓰는 방식입니다.
유지보수는 활발하지만 그만큼 아직 움직이는 중이에요. GitHub 릴리스 기준으로 첫 v0.1.0이 2026년 10월 20일, 최신 v0.10.0이 11월 7일이니 18일 사이에 15개가 나왔습니다. 절차와 평가가 안정되면 1.0.0으로 올린다는 계획이고요.
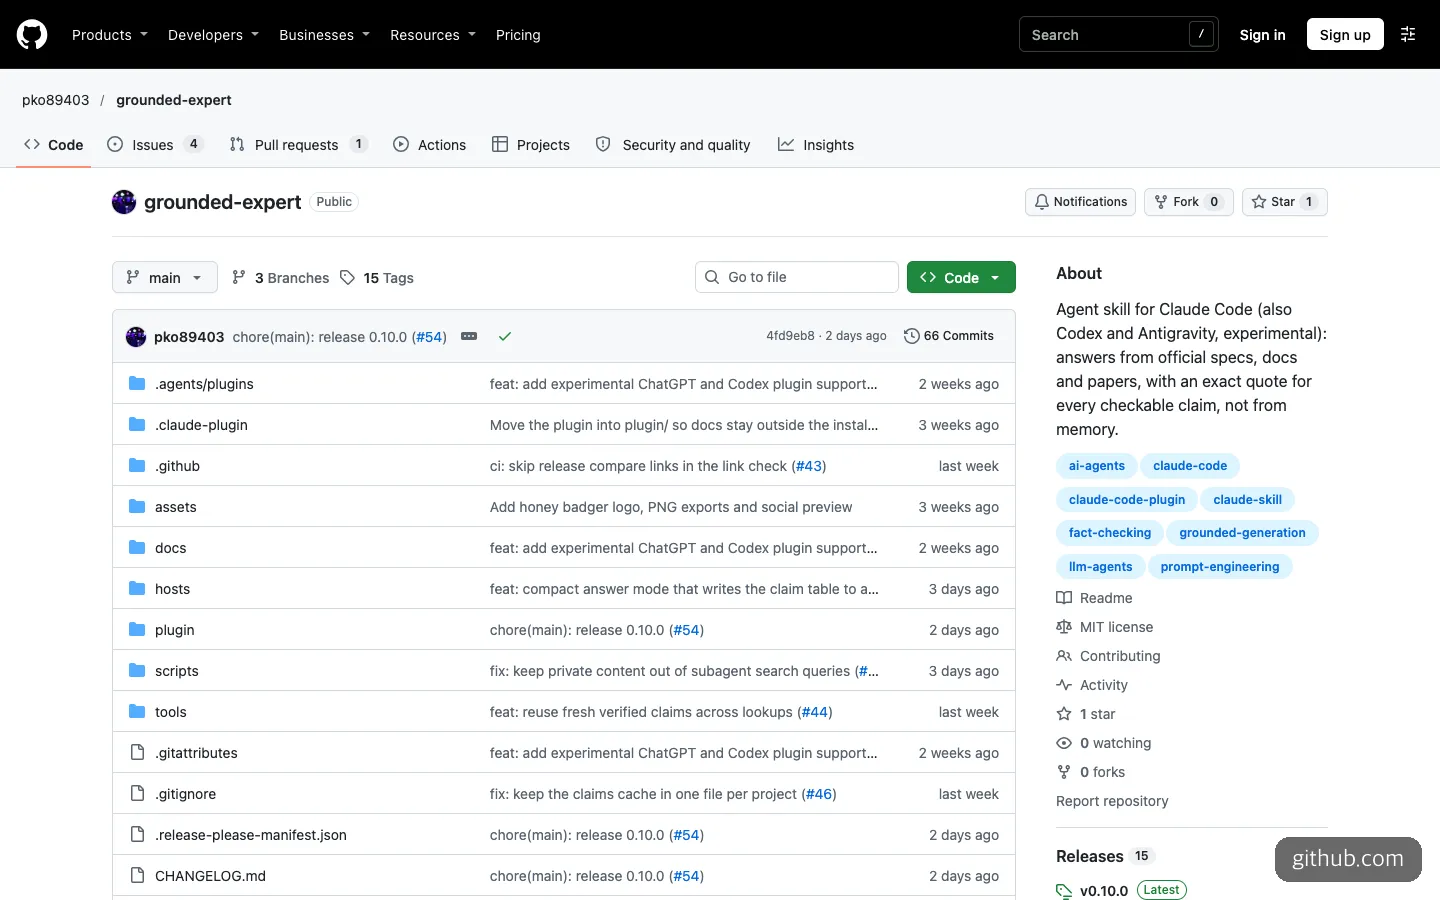
별 1개, 포크 0개인 저장소 첫 화면. 릴리스는 이미 15개까지 나왔어요.
보안 쪽에서는 클로드 코드 공식 문서의 경고를 기억해야 해요. 설치한 플러그인은 사용자 권한으로 임의 코드를 실행할 수 있고, 이 저장소처럼 개인이 운영하는 마켓플레이스는 서드파티에 해당합니다. 앞서 적은 설치 전 점검 요청이 그래서 필요하죠.
질문 내용도 조심할 대상이에요. 작성자에게 보내는 데이터는 없다고 하지만, 질문에서 만든 검색어는 검색 제공자로, 페이지 요청은 방문한 사이트로 갑니다. 검색어를 일반 용어로만 만들라는 규칙은 강제되지 않으니 고객 정보나 내부 서비스 이름은 질문에 넣지 않아야 해요.
사소하지만 눈에 걸린 점도 하나 있습니다. GitHub에서 지침 파일을 열면 맨 위에 YAML 오류를 알리는 빨간 배너가 떠요. 클로드 코드가 읽을 때도 문제가 되는지는 확인하지 못했지만, 처음 보는 사람에겐 불안한 첫인상이죠.
이지티켓의 판단은 이렇습니다. 지금은 매일 켜 둘 도구가 아니라, 틀리면 곤란한 질문 몇 개에 골라 거는 도구로 보는 편이 맞아요.
자주 묻는 질문
grounded-expert는 무료인가요?
코드는 MIT 라이선스로 무료예요. 다만 호출할 때마다 검색과 서브에이전트 실행에 드는 실제 사용량이 발생합니다. 평가 스위트를 돌릴 때도 마찬가지고요.
코덱스나 다른 AI 코딩 도구에서도 쓸 수 있나요?
코덱스와 Antigravity 지원은 실험 단계예요. Antigravity는 클로드 코드용 평가로 검증되지 않았고, 서브에이전트가 검색 도구를 받는지도 아직 확인되지 않았다고 README가 밝힙니다. 안정적으로 쓰려면 클로드 코드가 기준이에요.
코드를 잘 몰라도 쓸 수 있나요?
질문을 말로 적으면 되니 사용 자체는 어렵지 않아요. 영어 원문 인용이 낯설다면 표의 주장과 인용문이 정말 같은 뜻인지 AI에게 다시 풀어 달라고 하면 됩니다.
검증 기록은 어디에 남나요?
프로젝트의 .claude/grounded-expert/ 폴더에 참고 파일, 답변, 검증 기록(claims.md)을 저장할 수 있어요. claims.md에서 7일 지난 항목은 삭제됩니다. Git에 올리고 싶지 않다면 .gitignore에 추가하면 돼요.
참고한 자료 8
이 글은 AI가 자료 조사와 초안 작성을 돕고, 운영자가 직접 써 보고 확인해 고친 뒤 발행했어요. 틀린 내용을 발견하면 알려 주세요.